Posts Tagged with "BSV"

既に発行済みのブログであっても適宜修正・追加することがあります。
We may make changes and additions to blogs already published.
posted by sakurai on November 6, 2026 #1144

Claudeと議論し、既に開発済みの命令デコーダとパイプライン制御を拡張してどのように設計するかの方針を検討しました。従来のwait/cancel制御から現代的なFIFOで構成する方式に変更しています。

構成

  • ISAはRV32I + Zicsr、特権はMモードのみ(予定)。
  • パイプラインは<PC>, <IF>, <ID>, <EX>, <MA>, <WB>の6段です。<PC>は独立した段で、命令のPCは<PC>の最後で確定し、以後パイプラインに沿って流れます。
  • ツールはbsc(bsim / Verilog出力)、iverilog、Verilator、Yosys、Vivado、gtkwaveです。

設計方針

  1. デコーダは構造体を返す純関数にする。 <ID>が decode(Bit#(32)) -> DecInst を呼び、結果を次段へ渡します。パターン一致にはBitPatを使います。命令ごとの関数がDecInstを返し、switchで得た候補のリストをpickに渡すと、一致した命令の値が返ります。どれにも一致しない場合は、リストの最後に常に真の候補を置いて不正命令にします。DecInstには命令種別、ALU演算、rs1/rs2/rd、符号拡張済みimm、分岐条件、ロード/ストア幅、CSR番号、不正命令フラグを入れます。逆アセンブル表示はデバッグ用の関数として別に持ちます。
  2. 段間はパイプラインFIFOでつなぐ。 段間はmkPipelineFIFOです。<PC>→<IF>だけは、中身を読み返すlastメソッドを持つ自作のmkPipeQにします。wait信号もバブルも書きません。段のwaitは「その段のruleが発火しない」ことで表し、ハザードやメモリの応答待ちはruleの発火条件に書きます。下流が詰まれば、上流はFIFOが満杯になって同じサイクルに止まります。
  3. 段間データは素の構造体にする。 <PC>→<IF>は {pc, epoch}、<IF>→<ID>は {pc, epoch, inst}、<ID>→<EX>は {pc, epoch, DecInst, rs1値, rs2値} のように段ごとの型を定めます。FIFOに入っていること自体が「有効」なので、validもMaybeも持ちません。
  4. <PC>はPCの箱から次のPCを作る。 <PC>→<IF>の段間FIFO(mkPipeQ)が、ブロック図のPCの箱です。<PC>はその中身(直前に確定したPCとepoch)をlastで読み、+4します。redirectがあれば分岐先を選び、epochを反転します。<PC>専用のpcレジスタやepochレジスタはありません。PCの箱のリセット値は「リセットベクタ−4」です。
  5. 取り消しはepochで行う。 各命令はepochを1bit運びます。<EX>は分岐が成立したらexEpochを反転し、redirectレジスタ(mkCReg)に分岐先を書きます。redirectは、<PC>が使うまでレジスタに残ります。<ID>と<EX>は、epochが合わない命令をdeqだけしてenqせずに捨てます。<ID>でも比べるのは、誤った命令がハザードで無駄にwaitしないためです。取り消しはハザード判定より先に行います(キャンセルはwaitに勝つ)。
  6. ruleの実行順序を前提に設計する。 パイプラインFIFOではdeqがenqより先なので、ruleは<WB>→<MA>→<EX>→<ID>→<IF>→<PC>の順にスケジュールされます。<EX>が書いたredirectやexEpochを、同じサイクルの<ID>や<PC>がmkCRegの後ろのポートで読みます。<WB>の書き込みを同じサイクルの読み出しで使うため、レジスタファイルは書き込みバイパス付きにします。
  7. バイパスとインターロックは段の中身で判定する。 FIFOでは段の間隔が一定ではない(バブルが詰まる)ので、「ちょうど1wait」のような間隔を前提にした判定は使いません。下流の各段にいる命令のrdを近い段から順に調べ、最初に一致した命令の値を使います。値がまだ無ければ(ロード結果の未着など)、使う側の段のruleが発火しません。見つからなければレジスタファイルの値を使います。この判定は、段の間隔によらず正しく動きます。
  8. メモリはBRAMで作り、キャッシュは同じインタフェースの裏に入れる。 req/data形式の同期BRAMを使い、<PC>でreq、<IF>でdataを受けます。データ側は<EX>でreq、<MA>でdataです。キャッシュと仮想記憶は、プロセッサの完成後に同じインタフェースの裏に入れます。ミス時の応答未着は、<IF>や<MA>のruleが発火しない理由になります。
  9. 検証では任意の段を止められるようにする。 waitの実際の発生源は、メモリの応答未着、マルチサイクル演算器、ハザードです。これとは別に、テストベンチから任意のサイクルで任意の段を止める条件を、各段の発火条件に足せるようにします。

ブロック分割

パイプライン本体(mkProcessor)は6段のruleと段間FIFOだけを持ち、計算や記憶はすべて別モジュールか純関数に出します。段のruleは「部品を呼んで次段へ渡す」だけになり、部品は単体で検証できます。
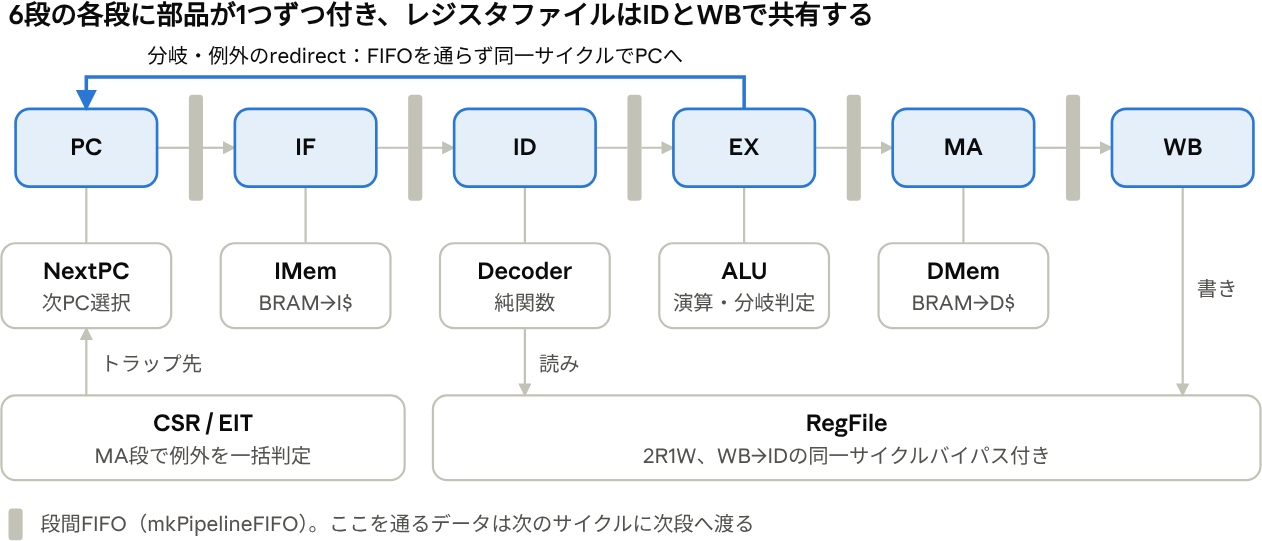
ブロック分割

灰色の帯が段間FIFOです。<EX>/<MA>から<ID>へのフォワーディングは図では省いています。

ファイル 中身 形 使う段
Types.bsv Addr, Data, Inst, DecInst, 段間構造体(IF2ID など) 型定義 全段
PipeQ.bsv lastメソッド付きの1段パイプラインFIFO(PCの箱) モジュール <PC>・<IF>
Decoder.bsv decode(Bit#(32)) -> DecInst、即値生成を含む 純関数 <ID>
RegFile.bsv 32x32bit、x0固定ゼロ、2読み1書き、書き込みバイパス モジュール <ID>読み、<WB>書き
Alu.bsv alu(op, a, b)、brCond(cond, a, b)、分岐先計算 純関数 <EX>
NextPC(mkProcessor内) PCの箱+4 / 分岐先 / トラップ先の選択、epochの反転 rule <PC>
Mem.bsv req/resp型のメモリIF、BRAMCoreによるIMem・DMem。DMemはバイトイネーブル付き モジュール <PC>・<IF>、<EX>・<MA>
Csr.bsv mstatus, mtvec, mepc, mcause など。ecall/mret、例外の一括判定 モジュール <EX>〜<WB>
Processor.bsv 6段のrule、段間FIFO、発火条件とepochの制御、ハザード検出 モジュール —
Tb.bsv ほか検証環境 プログラムのロード、終了判定、トレース出力、期待値比較 テストベンチ (Claude担当)

後から足す部品は、ICache/DCache(Mem.bsvと同じインタフェースの裏に入れる)、乗除算器、BTB(<PC>での予測)です。

設計順序

「命令が実際に流れる」状態を早く作り、以後は常にriscv-testsで回帰確認できる順にします。各ステップの終わりで確認し、次へ進みます。ハザードは最初はストールだけで正しく動かし、フォワーディングは性能改善として後から入れます。

  1. 検証環境(Claude)
    • RISC-V GCCでriscv-tests(rv32ui-p)とfibo.cをビルドし、$readmemh用の.memを作る。
    • Makefile、bsimとVerilatorの両実行、tohost書き込みでの合否判定、コミットログ出力を用意する。
    • 期待値はISS(Spike)のコミットログと照合する。
  2. Types.bsvと段間FIFO
    • 段間構造体、mkPipelineFIFO、mkPipeQで6段をつなぐ。各段を止めるテスト用の発火条件とepochもここで入れる。
    • 完了条件:任意の段を任意のサイクルで止めるテストで、期待どおりのタイミングになる。
  3. IMemと<PC>/<IF>
    • BRAMCoreでIMemを作り、<PC>でreq、<IF>で命令を受け取る。
    • 完了条件:<ID>で逆アセンブル表示を出し、fiboのobjdumpと一致する。
  4. Decoder、RegFile、ALU
    • decodeでDecInstを作り、<EX>で演算、<WB>で書き戻す。データハザードは<ID>の発火条件で止める。
    • 完了条件:rv32uiの演算系(add, addi, sub, and, or, xor, sll, srl, sra, slt, lui, auipc など)が通る。
  5. DMemとロード/ストア
    • <EX>でアドレス計算とreq、<MA>で受け取り、バイト/ハーフワードの整列と符号拡張。
    • 完了条件:lb/lh/lw/lbu/lhu/sb/sh/swが通る。
  6. 分岐とジャンプ
    • <EX>で分岐を解決し、<PC>へredirect。epoch不一致の命令は<ID>と<EX>で捨てる。予測は「常に非分岐」から始める。
    • 完了条件:rv32ui-p全テストとfiboが通る。
  7. フォワーディング
    • <EX>→<EX>、<MA>→<EX>のバイパスを、方針7の判定で入れる。
    • 完了条件:段をランダムに止めても結果が変わらず、サイクル数が減る(CPIを計測)。
  8. CSRとEIT
    • Zicsr、ecall/ebreak/mret、不正命令・アドレス例外を<MA>で一括判定する。
    • 完了条件:rv32mi-pの主要テストが通る。
  9. キャッシュ
    • プロセッサ完成後の別フェーズ。Memのインタフェースは変えずに裏をICache→DCacheに差し替え、その後に仮想記憶(TLB)を加える。
    • 完了条件:全テストがそのまま通り、ミス率とCPIを計測できる。
  10. 拡張(任意):M拡張、BTB、FPGA実装。

未決事項

  • [ ] ソースの置き場所。git svnでGitHubのprivateリポジトリへ移行する。リポジトリ名待ち
  • [ ] 対象ISAはRV32I + Zicsr、特権はMモードのみでよいか
  • [ ] 最終ターゲットのFPGA(Ultra96、Arty など)。BRAM容量とキャッシュの要否に効く

左矢前のブログ 次のブログ右矢

posted by sakurai on November 5, 2026 #1143

パイプライン制御をFIFOで考える

動機

これまでのPipeline processorの設計シリーズでは、段間を普通のパイプラインレジスタでつなぎ、制御を2つの信号で表してきました。

  • wait:その段のレジスタに書き込ませない。実質的にはゲーテッドクロック(enable)です。上流へは W(S-) = W(S) ∪ W(S+) で伝えます。
  • cancel:validを落として、その命令を泡にします。

これは教科書どおりの考え方ですが、現代の設計、特にBSVのような高位の記述では、段間を「FIFO」とみなして、送る側と受ける側のハンドシェイクで制御するのが普通です。この記事では、従来のwait/cancelの考え方がFIFOのどこに入っているのかを対応づけ、BSVでの書き方を示します。

パイプラインFIFOの中身

BSVのmkPipelineFIFOは、中身は1段のレジスタにfull bitを1つ足しただけの小さな回路です。

  • deq(取り出し)できる条件:full
  • enq(書き込み)できる条件:!full、または同じサイクルにdeqされる

この「同じサイクルにdeqされるならenqできる」があるので、全段が詰まっていても毎サイクル1命令ずつ流れます。動作はパイプラインレジスタと同じです。

違いは、制御をFIFO自身が持っていることです。full bitが従来のvalid bitに当たり、「enqできる」がwaitの否定に当たります。

従来手法との対応

従来手法 FIFO
valid bit full bit(FIFOに入っていること自体が有効)
wait W(S) 入力側FIFOからdeqしない(ruleが発火しない)
下流からのwait W(S+) 出力側FIFOが満杯でenqできない
泡(validを落として送る) 何もenqしない(FIFOが空のまま)
cancel deqしてenqしない
enable(ゲーテッドクロック) enqの成立

waitもvalidも、FIFOの中に入っています。そのため、BSV流に書くとwait信号も泡も一切書きません。

違いは泡の扱い

1つだけ、動作が変わる所があります。従来の式 W(S-) = W(S) ∪ W(S+) では、下流がwaitすると上流はすべて止まります。間に泡がいても止まります。

FIFOでは、出力側のFIFOが空(泡)なら、下流が止まっていても受け取れます。式で書くと、W(S+)の項にvalidが掛かります。

W(S-) = W(S) ∪ (v(S) ∧ W(S+))

泡があれば詰められるので、その分だけ速くなります。サイクル8に<IF>が1回waitして泡を作り、サイクル10と11に<EX>がwaitする場合をbsimで比べました。

従来手法(レジスタ+wait) FIFO
サイクル10の<ID> 止まる 020cを<EX>側のFIFOへ送る
020cが<EX>に着く サイクル13 サイクル12

FIFOでは、<EX>が止まっている間に<ID>が泡の位置へ命令を進めるので、1サイクル早くなりました。

BSVで書く

段間データは段ごとの構造体です。validもMaybeも持ちません。

typedef struct { Addr pc; Bool epoch; }            PC2IF deriving (Bits, Eq);
typedef struct { Addr pc; Bool epoch; Inst inst; } IF2ID deriving (Bits, Eq);
typedef struct { Addr pc; Bool epoch; Bool isBr; Addr target; } ID2EX deriving (Bits, Eq);

<ID>は、ハザードがあれば発火しません。これがwaitです。上流は、<ID>がdeqしないので入力側のFIFOが満杯になり、自然に止まります。取り消す命令はdeqするだけで、次段へは何も送りません。

// <ID>
Bool idKill = ids.first.epoch != exEpoch[1];
Bool idHaz  = hazard(ids.first);

rule id_kill (idKill);              // 取り消し:deqしてenqしない
   ids.deq;
endrule

rule id_stage (!idKill && !idHaz);  // ハザード中は発火しない(=wait)
   let x = ids.first; ids.deq;
   exs.enq(ID2EX { pc: x.pc, epoch: x.epoch, isBr: isBranch(x.inst), target: brTarget(x) });
endrule

<EX>は、epochが合わない命令を捨て、分岐が成立したら<PC>へredirectを送ります。

// <EX>
rule ex_stage;
   let x = exs.first; exs.deq;
   if (x.epoch == exEpoch[0] && x.isBr) begin
      redirect[0] <= tagged Valid x.target;   // <PC>のMuxへ
      exEpoch[0]  <= !exEpoch[0];
   end
endrule

waitなし、<IF>のwait、誤った命令の<ID>でのハザード、正しい命令の<ID>でのハザードの4通りを、従来手法のレジスタ版と比べました。分岐まわりのタイミングはすべて同じで、ロジックの行数は約半分(85行と44行)になりました。

注意点

  • FIFOの暗黙条件はrule全体を止めます。止まってほしくない処理を同じruleに入れてはいけません。たとえば<EX>からのredirectを<PC>のruleがRWireで受けると、<PC>が止まっているサイクルにredirectが消えます。redirectは、<EX>が書くレジスタ(mkCReg)で受けます。
  • 標準のFIFOは、deqした後に残っているデータをインタフェースから読めません。<PC>のように「自分が最後に出した値」に+4したい所では、中のレジスタを読むlastメソッドを足した自作のFIFOを使います。
  • 下流のwaitが上流へ組合せ回路で伝わる点は、従来手法と変わりません。FIFOの「enqできる」は下流のdeqで決まるので、<WB>から<PC>までの経路の長さは同じです。

左矢前のブログ 次のブログ右矢

posted by sakurai on November 4, 2026 #1142

epochによるキャンセル制御

分岐が成立すると、分岐命令より後ろで既にフェッチした命令を取り消す必要があります。Pipeline processorの設計(13)では、分岐を<ID>で解決していました。分岐が成立したら、同じサイクルにPCの選択Muxで分岐先を選び、後続の命令にinvalidを流してキャンセルします。Pipeline processorの設計(19)の式 V(S+) = N(!W(S) ∪ W(S+)) ∩ !C(S+) のC(S+)が、このキャンセルにあたります。

段をパイプラインFIFOでつなぐBSVの構成では、もう少し簡単な方法があります。各命令に1bitの「epoch」を付けて流し、どの段も「古いepochの命令が来たら捨てる」という同じ規則で動きます。捨てるのは、FIFOから取り出すだけで次の段へ入れない(deqしてenqしない)ことです。validを落とすという操作そのものが要りません。

仕組み

epochのレジスタは<EX>のexEpochだけです。<PC>側のepochは、PCの箱(<PC>と<IF>の間の段間FIFO)の中に、PCと一緒に入っています。

  1. <PC>は、PCの箱の中身(直前に確定したPCとepoch)を読み、PC+4に同じepochを付けて出す。
  2. <EX>は、命令のPCと即値から分岐先を計算する。分岐が成立したらexEpochを反転し、<PC>へ分岐先を送る(redirect)。
  3. <PC>はredirectを受けたら、分岐先に反転したepochを付けて出す。
  4. <IF>、<ID>、<EX>の各段は、命令のepochがexEpochと一致しなければ、その命令を捨てる。

epochは、redirectの回数を数える世代番号の最下位ビットだと考えると分かりやすいです。

取り消しの規則は全段で同じです。どの段も、自分の処理より先にepochを比べ、古ければ捨てます。

タイミング

0100番地の分岐命令が成立し、0200番地へ飛ぶ例です。各列は、その段にいる命令のPCで、括弧内はその命令のepochです。<PC>列は、そのサイクルの終わりにPCの箱に入る値です。

サイクル <PC> <IF> <ID> <EX> exEpoch 動作
1 0100(0) 0
2 0104(0) 0100(0) 0
3 0108(0) 0104(0) 0100(0) 0
4 0200(1) 0108(0) 0104(0) 0100(0) 0→1 分岐成立。exEpochを反転し、同じサイクルに<PC>が分岐先を選ぶ。<IF>は0108、<ID>は0104を捨てる
5 0204(1) 0200(1) 1
6 0208(1) 0204(1) 0200(1) 1
7 020c(1) 0208(1) 0204(1) 0200(1) 1 分岐先を実行

分岐ペナルティは2サイクルです。この表は、下のコードをbsc 2025.07でコンパイルし、bsimとiverilogで同じ結果になることを確認したものです。

サイクル4では、<EX>の分岐判定と分岐先の計算が、同じサイクルのうちに<PC>のMuxまで組合せ回路でつながっています。つまりこのサイクルの<PC>の出力は、事実上<EX>が決めています。<PC>が<EX>の次のサイクルに動くわけではありません。同じサイクルの<IF>と<ID>も、<EX>が反転したexEpochを見て、0108と0104を捨てます。誤った命令は、すべてサイクル4のうちに消えます。

パイプラインFIFOでは、下流の段のruleが先にスケジュールされます(<EX>→<ID>→<IF>→<PC>)。そのため、<EX>が書いた値を同じサイクルの<ID>、<IF>、<PC>が読めます。exEpochはmkCRegで、ポート0を<EX>、1を<ID>、2を<IF>が使います。mkCRegはPreludeにある並行レジスタで、MITのArvindらの言うEHR(Ephemeral History Register)と同じものです。ポート0が書いた値を、同じサイクルのポート1以降が読めます。ポート数の上限は5です(BSC Libraries Reference Guide 2.4.2)。

1bitで足りる理由

exEpochが2回目に反転するのは、新epochの有効な分岐命令が<EX>に着いたときです。その命令は、<PC>がredirectを受けた後に出したものです。FIFOでは追い越しが起きないので、それより前に出た旧epochの命令は、すべて捨てられたか<EX>を通り過ぎています。

つまり、パイプライン中に同時に存在する世代は「旧」と「新」の最大2つです。世代番号の上位ビットは不要で、LSBだけで区別できます。条件は、redirectを出す段が1つであることと、段間が順序を保つFIFOであることです。

BSVの例

段間のデータは素の構造体です。分岐判定は省略して、<ID>が作ったisBrとtargetで表しています。

typedef struct { Addr pc; Bool epoch; }            PC2IF deriving (Bits, Eq);
typedef struct { Addr pc; Bool epoch; Inst inst; } IF2ID deriving (Bits, Eq);
typedef struct { Addr pc; Bool epoch; Bool isBr; Addr target; } ID2EX deriving (Bits, Eq);

// PCの箱。lastで中身を読み返せる1段のパイプラインFIFO
PipeQ#(PC2IF)      ifs         <- mkPipeQ(PC2IF { pc: 'h100 - 4, epoch: False });
FIFO#(IF2ID)       ids         <- mkPipelineFIFO;
FIFO#(ID2EX)       exs         <- mkPipelineFIFO;
Reg#(Bool)         exEpoch[3]  <- mkCReg(3, False);           // [0]:EX, [1]:ID, [2]:IF
Reg#(Maybe#(Addr)) redirect[2] <- mkCReg(2, tagged Invalid);  // [0]:EX, [1]:PC

// <EX>
rule ex_stage;
   let x = exs.first; exs.deq;
   if (x.epoch == exEpoch[0]) begin
      // ここで演算し、MAへenqする
      if (x.isBr) begin
         redirect[0] <= tagged Valid x.target;   // PCのMuxへ
         exEpoch[0]  <= !exEpoch[0];
      end
   end
   // epochが合わない命令はdeqするだけ(enqしない)で捨てる
endrule

// <ID>  取り消す命令は捨てる。ハザード中は発火しない(=wait)
Bool idKill = ids.first.epoch != exEpoch[1];   // EXが今反転した値を見る
Bool idHaz  = hazardCheck(ids.first);

rule id_kill (idKill);
   ids.deq;                                     // enqしない
endrule

rule id_stage (!idKill && !idHaz);
   let x = ids.first; ids.deq;
   exs.enq(ID2EX { pc: x.pc, epoch: x.epoch, isBr: x.inst == 1, target: 'h200 });
endrule

// <IF>  取り消す命令は捨てる
Bool ifKill = ifs.first.epoch != exEpoch[2];

rule if_kill (ifKill);
   ifs.deq;                                     // enqしない
endrule

rule if_stage (!ifKill);
   let x = ifs.first; ifs.deq;
   ids.enq(IF2ID { pc: x.pc, epoch: x.epoch, inst: imem(x.pc) });
endrule

// <PC>  PCの箱(ifs.last) → +4 → Mux(redirect優先) → PCの箱
rule pc_stage;
   let cur = ifs.last;
   Addr p = cur.pc + 4;
   Bool e = cur.epoch;
   if (redirect[1] matches tagged Valid .t) begin
      p = t;
      e = !cur.epoch;
      redirect[1] <= tagged Invalid;
   end
   ifs.enq(PC2IF { pc: p, epoch: e });   // ここでPCが確定
endrule

PCの箱のリセット値は「リセットベクタ−4」です。最初のサイクルに<PC>が+4して、リセットベクタを出します。<PC>専用のpcレジスタやepochレジスタはありません。RISC-V パイプラインプロセッサ 設計方針のブロック図にあるPCの箱が、ifsそのものです。確定したPCとepochは、そこに入っています。

<ID>のwaitは、id_stageの発火条件!idHazそのものです。waitの線も泡も書きません。<ID>が発火しなければidsが満杯のまま残り、<IF>と<PC>はenqできずに止まります。取り消しはハザードより先に判定します(!idKill &&)。これが「キャンセルはwaitに勝つ」という規則にあたります。

mkPipeQは、標準のmkPipelineFIFOに、中のデータレジスタを読み出すlastメソッドを足しただけのものです。

interface PipeQ#(type t);
   method Action enq(t x);
   method t      first;
   method Action deq;
   method t      last;     // 最後にenqされた値(deq後も残っている)
endinterface

module mkPipeQ#(t init)(PipeQ#(t)) provisos (Bits#(t, tSz));
   Reg#(t)    d       <- mkReg(init);
   Reg#(Bool) full[2] <- mkCReg(2, False);   // [0]:deq側, [1]:enq側
   method Action enq(t x) if (!full[1]);
      d <= x;
      full[1] <= True;
   endmethod
   method t first if (full[0]) = d;
   method Action deq if (full[0]);
      full[0] <= False;
   endmethod
   method t last = d;
endmodule

注意点

  • 取り消される命令は、捨てられるまでは普通に流れます。そのため、捨てられる前の段(<IF>/<ID>)でアーキテクチャ状態を変えてはいけません。

<IF>で捨てるとき

命令メモリへの要求は<PC>で出しているので、<IF>は捨てる命令でも、メモリの応答を受け取ってから捨てます。そうしないと、要求と応答の対応がずれます。

組合せ回路の経路

<EX>の分岐判定から、<PC>のMuxを通ってIMemのアドレス(<PC>でreq)まで、同じサイクルの組合せ回路でつながります。<IF>と<ID>の取り消しも同じサイクルにつながります。これがクリティカルパスになるなら、redirectや<ID>の比較を1サイクル遅らせます。その場合、分岐ペナルティは3サイクルになります。この形はまだシミュレーションしていません。

<PC>が動けないサイクルのredirect

<IF>がwaitしてPCの箱が満杯なら、enqの暗黙条件によって<PC>のrule自体が発火しません。redirectを「そのサイクルだけ見える線」で渡すと、このサイクルのredirectは誰にも受け取られずに消えます。exEpochはもう反転しているので、以後<PC>が出す命令はすべてepochが合わず、取り消され続けます。

redirectをCReg、つまりレジスタにしているのはこのためです。<EX>が書いた値は、<PC>が実際に命令を出して消すまで残ります。サイクル4に<IF>をwaitさせた場合をbsimで確かめました。

サイクル <PC> <EX> 動作
4 (発火しない) 0100(0) 分岐成立。redirectはレジスタに残る
5 0200(1) <PC>が残っていたredirectを使う
8 020c(1) 0200(1) 分岐先を実行

redirectが残っている間は、新しいepochの命令がまだ<PC>から出ていません。そのため次のredirectが重なることはありません。

redirectを出す段が複数ある場合

1bitで足りるという議論は、redirectを出す段が1つであることが前提でした。<MA>での例外や、<ID>でのBTB予測の修正のように、redirectを出す段が増えると、1本のepochでは足りません。

たとえば<MA>で例外が起きたとします。その後ろの<EX>、<ID>、<IF>にいる命令は、すべて取り消す必要があります。ところが<EX>は、<MA>がredirectを出したことを自分のexEpochでは知ることができません。そのため、取り消すべき命令を<EX>がそのまま実行します。その中に分岐があれば、誤ったredirectまで出してしまいます。

そこで、redirectを出す段ごとに1bitのepochを持たせます。命令は(exEpoch, maEpoch)の2bitを運び、各段は自分より後ろの段のepochもすべて比べます。<EX>は2bitとも比べ、<MA>はmaEpochだけを比べます。それぞれのepochは自分の段のredirectでしか反転しないので、1bitで足りる理由は段ごとにそのまま成り立ちます。同じサイクルに2つのredirectが来たら、<PC>は古い命令の方、つまり後ろの段(<MA>)を優先します。この部分は、例外を実装する回で動かして確かめます。

キャンセル信号方式との比較

Pipeline processorの設計(13)では、分岐を<ID>で解決していたので、取り消すのは後ろの1命令(<IF>にいる命令)だけでした。その命令のvalidを落とし(Pipeline processorの設計(19)のC(S+))、invalidが後段へ流れていきます。

本稿では分岐を<EX>で解決するので、取り消す命令は<IF>と<ID>の2つになります。キャンセル信号でこれを行うなら、<EX>から<IF>と<ID>の両方にキャンセル信号を配り、同じサイクルに2つのvalidを落とすことになります。epoch方式では、段に配るキャンセル信号がありません。命令に1bitを付けて一緒に流し、各段で比べるだけです。段が増えても配線は増えません。

このキャンセル信号方式では、サイクル4の時点で0104と0108が同時に無効になります。epoch方式でも、0104と0108はサイクル4に捨てられます。結果は同じで、分岐ペナルティもどちらも2サイクルです。違いは、キャンセル信号を配る代わりに、各段が自分で「古い命令か」を判定する点です。


左矢前のブログ 次のブログ右矢

俺の勉強会#8 LT予告

posted by sakurai on October 19, 2026 #1138

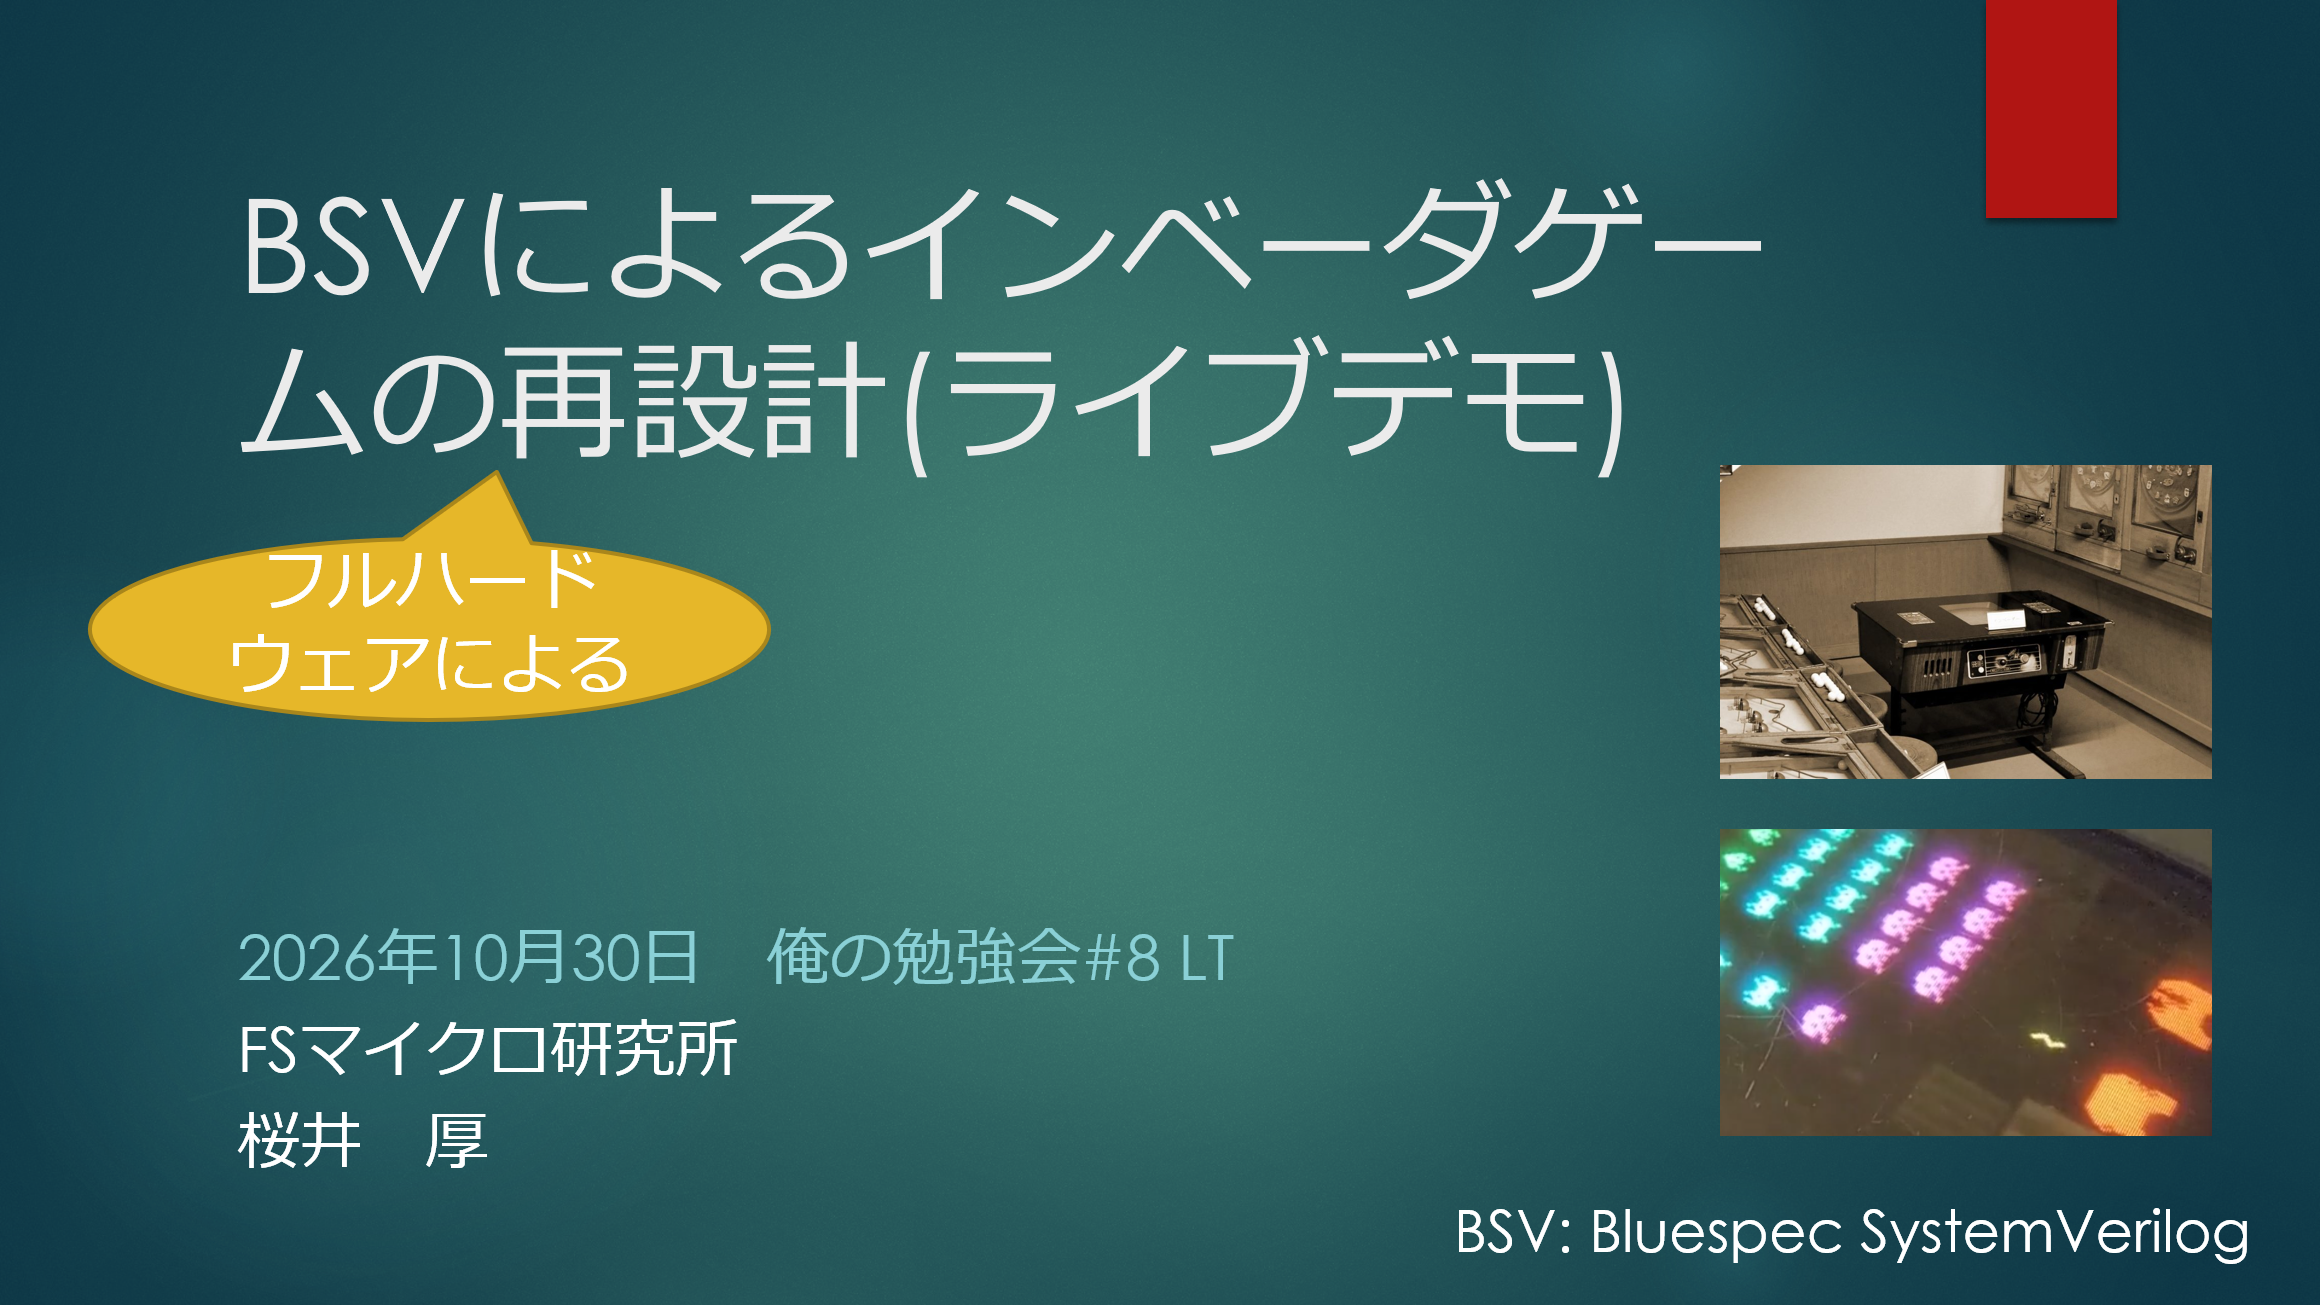
俺の勉強会#8においてLTを行います。テーマは「BSVによるインベーダゲームのフルハードウエアによる再設計」というもので、ライブデモを行います。

図1138.1
図1138.1 俺の勉強会#8

図1138.2
図1138.2 BSVによるインベーダゲームのフルハードウエアでの再設計

以下に目次を示します。

  • 自己紹介と用語
  • Bluespec SystemVerilog (BSV)
  • BSVのサンプルプログラム
  • 私的インベーダ設計の歴史
  • 私的インベーダ設計の歴史 (2)
  • 機材
  • まとめ
  • ライブデモ実行

左矢前のブログ 次のブログ右矢

メモリをBSVで書く (5)

posted by sakurai on October 5, 2026 #1136

4点目 運用

bsc付属のライブラリVerilogが3つ増えました。mkFIFOF1のFIFO1.v、mkBRAMCore1LoadのBRAM1Load.v、mkSyncBRAMCore2LoadのBRAM2Load.vで、bscはこれらを生成せず、インストール先のlib/Verilogにあるものをインスタンスします。教科書版のMakefileはこれをsrcに写して、生成Verilogと同じ扱いにします。

# bsc 付属の Verilog ライブラリ。mkBlitter が使う FIFO1 と BRAM1Load、
# mkVram が使う BRAM2Load はここから src に写す
BSC_VLIB     ?= $(abspath $(dir $(shell which $(BSC)))../lib/Verilog)
BSC_LIB_V    := FIFO1.v BRAM1Load.v BRAM2Load.v
$(addprefix $(RTL_DIR)/,$(BSC_LIB_V)): $(RTL_DIR)/%.v: $(BSC_VLIB)/%.v
	@mkdir -p $(RTL_DIR)
	cp $< $@

1つのソースから2つのモジュールを出す規則は、グループターゲットで3つの生成物を1回のレシピに結びます。Blitter.bsvからはmkBlitter.vとmkProm.vとBlitter.bo、SoundFSM.bsvからは変種ごとにmkSoundFSMn.vとmkSoundROMn.vです。

$(RTL_DIR)/mkBlitter.v $(RTL_DIR)/mkProm.v $(VOBJ_DIR)/Blitter.bo &: $(SRC_DIR)/Blitter.bsv
	@mkdir -p $(RTL_DIR) $(VOBJ_DIR)
	$(TIME) $(BSC) $(BSC_RT_OPTS) $(VLOG_FLAGS) $(PFLAGS) $(STEPFLAGS) \
	    -bdir $(VOBJ_DIR) -vdir $(RTL_DIR) -g mkBlitter -g mkProm $(SRC_DIR)/Blitter.bsv
$(RTL_DIR)/mkSoundFSM0.v $(RTL_DIR)/mkSoundROM0.v &: $(SRC_DIR)/SoundFSM.bsv $(SRC_DIR)/SoundCodes.vh
	$(call BSC_GEN_D,mkSoundFSM0 mkSoundROM0,$(SRC_DIR)/SoundFSM.bsv,FSM0)

make checkはライブラリ3つの所在も確認します。ライブラリが別の場所にあるときはmake BSC_VLIB=場所で指定します。Vivadoには、srcの他の.vと同様にこの3つと、新しく増えたmkProm.v、mkVram.v、mkSoundROM0.vから3を登録します。memの.memはライブラリのVerilogの中から同じ名前で読まれるので、登録は今までのままです。

手書きVerilogからはvram.v、rom.v、sndch.vが消え、master.vからROMのインスタンスが消えました。残るのはtop.v、clock.v、master.v、sound.vの4つで、clock.vのMMCMと分周以外は配線です。

Yosysで試すときは1つ注意があります。read_verilogに-deferを付けないと、BRAM1Load.vがパラメータの既定値である空のファイル名で$readmemhを評価して止まります。-deferを付けると、パラメータが確定してから本体を解釈します。

まとめ

比べる前は、ブリッタの起動をFIFOにした版で、ROMとVRAMは手書きVerilogです。後はこの記事の3点を入れた版です。LUTとFFはYosysのsynth_xilinxでフラットに合成した概算で、mkGameFSMの行はmkBlitterとmkPromを含みます。動作はVerilatorでmkGameFSMを1,200万サイクル回し、VRAM書き込みとサウンドコードの系列と時刻を比べました。

メモリのBSV化前後 前 後 備考
ソース Blitter.bsvとGameFSM.bsv[行] 1,870 1,883 mkPromを足し、ポート2つとレジスタ1つが消えた
Vram.bsv[行] 0 41 vram.vの34行が置き換わった
SoundFSM.bsv[行] 261 306 rom.vの26行とsndch.vの65行が置き換わった
生成Verilog[行] 32,863 32,911 mkBlitter.v、mkProm.v、mkGameFSM.vの合計
mkBlitter LUT 183 198 ROMを3個のBRAMに分ける選択論理
FF 160 149 p_addrの15ビットが消えた
RAMB36 0 3 mkProm 25728 x 4
mkGameFSM LUT 5,695 5,790 後はROMを含む
FF 2,168 2,157
mkVram RAMB36 8 8 前はvram.v
mkSoundFSMn ポート 2本 0本 rom_addressとrom_dataが消えた
動作 mkGameFSMの系列と時刻 一致 1,200万サイクル
サウンド4チャネルの出力 一致 300万サイクル、852コマンド

mkGameFSMのLUTが95増えていますが、前の値にはmaster.vにあったROMが入っていません。ROMの3個のBRAMを選ぶアドレスの比較と出力の選択がmkGameFSMの側に移った分で、設計全体では増えていません。FFの減りはp_addrの15ビットそのもので、読み出しデータのレジスタはBRAMの出力レジスタに置き換わりました。

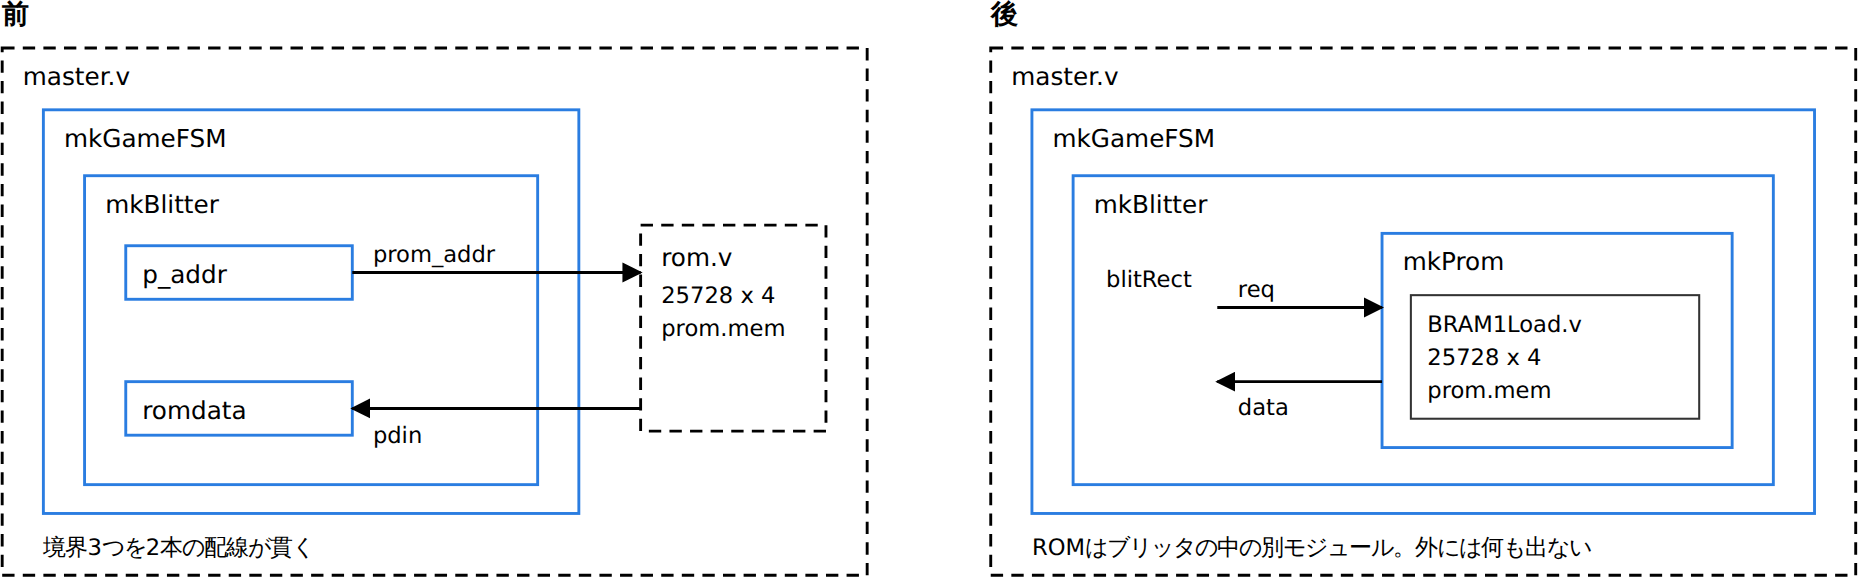
メモリをBSVに移して得たものは、ブリッタのインタフェースからROMが消えたことです。ROMを読むのはブリッタだけなのに、アドレスとデータの2ポートがブリッタ、mkGameFSM、master.vの3階層を貫いていました。使う側の中に置けば、その経路は丸ごと要らなくなります。一方でFSMとROMは機能が別なので、ブリッタの中でもmkProm、サウンドFSMの中でもmkSoundROMnという別のモジュールにし、FSMはそれをメソッドで呼びます。パターンROMとサウンドROMが同じ形になりました。VRAMは2つのクロック域にまたがるのでトップに残りますが、クロックを引数で受けるBSVのモジュールになり、手書きVerilogは配線とクロック生成だけになりました。


左矢前のブログ 次のブログ右矢

メモリをBSVで書く (4)

posted by sakurai on October 4, 2026 #1135

3点目 サウンドROMをmkSoundROMにする

図1135.1
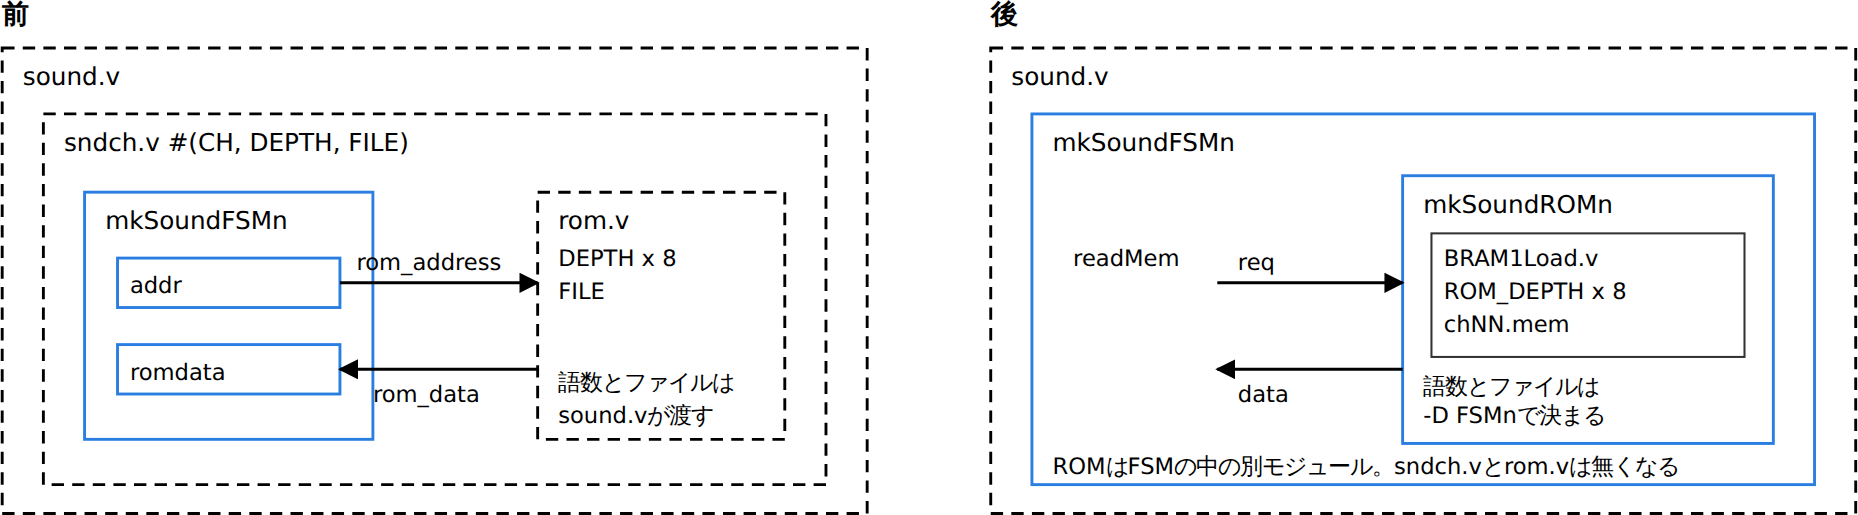
図1135.1 Sound ROM書き換え前後

サウンドは4チャネルあり、チャネルごとに手書きのsndch.vがFSMのmkSoundFSMnとROMのrom.vを並べ、rom_addressとrom_dataの2本で結んでいました。パターンROMと同じ形にして、ROMをmkSoundROMnという別モジュールにし、FSMがその中に置いてメソッドで呼ぶようにしました。FSMはWAVを読んでPCMを出す機能、ROMは内容を持つ機能で、機能が別なので別モジュールのままです。

書き換え前のsndch.vはCHに加えてDEPTHとFILEをパラメータに取り、sound.vがチャネルごとに語数とファイル名を渡していました。

module sndch #(
   parameter CH    = 0,
   parameter DEPTH = 21650,
   parameter FILE  = "ch00.mem"
) (
   rom #(.WIDTH(8), .AWIDTH(15), .DEPTH(DEPTH), .FILE(FILE)) u_rom (
      .clk  (clk),
      .addr (rom_addr),
      .q    (rom_q)
   );
   sndch #(.CH(0), .DEPTH(21650), .FILE("ch00.mem")) u_ch0 (

FSMの側は、アドレスをレジスタaddrに置いてrom_addressポートから出し、rom_dataポートから毎周期romdataレジスタに取り込んでいました。

書き換え前

interface FSM_ifc;
   method Action sound(SoundCode_t incode);
   method Action rom_data(Data_t indata);
   method Action sync(Bool lrclk);
   method Action empty(Bool flag);
   method Addr_t rom_address();
   method Data_t sdout();
   method Bool soundon();
   method Bool fifo_ren();
endinterface
   Reg#(Data_t) romdata <- mkRegU,      // ROM 読み出しデータ(毎サイクル入力)
                   dout <- mkReg(`NULL); // PCM 出力(無音=`NULL)
   Reg#(UInt#(32)) workd <- mkRegU;
   Reg#(UInt#(15)) dcount <- mkRegU;    // 残りサンプル数(WAV data チャンクサイズ)
   Reg#(Addr_t) worka <- mkRegU,        // readMem への引数(読みたい番地)
                   romaddr <- mkRegU,   // WAV 読み出しポインタ
                   addr <- mkReg(0);      // rom_address ポートへの出力値
   function Stmt readMem;
      return (seq
         addr <= worka;
         noAction;
         noAction;
      endseq);
   endfunction
            if (ii == 3) dcount <= truncate(workd<<8) | extend(romdata);
            else workd <= workd<<8 | extend(romdata);
   method Action rom_data(Data_t indata);
      romdata <= indata;
   endmethod
   method Addr_t rom_address();
      return addr;
   endmethod

書き換え後は、SoundFSM.bsvの末尾にROMのモジュールを足しました。FSMと同じ-D FSM0から3で作り分け、語数とファイル名は変種ごとにここで決まります。

// =================================================================
// SoundROM: 効果音 ROM(1ソース4変種)
//   FSM と同じ -D FSM0〜FSM3 で mkSoundROM0〜3 を作り分け、語数と
//   ファイル名を変種毎に持つ。実体は BRAMCore ライブラリの
//   mkBRAMCore1Load で、生成 Verilog では bsc 付属の BRAM1Load.v が
//   $readmemh でファイルを読む。req したアドレスの内容が次の周期から
//   data に出て次の req まで保持される同期 ROM。
//   FSM とは機能が別なので、同じソースに置くが別モジュールにしてある。
// =================================================================
`ifdef FSM0
`define ROM_DEPTH 21650
`define ROM_FILE  "ch00.mem"
`elsif FSM1
`define ROM_DEPTH 4622
`define ROM_FILE  "ch01.mem"
`elsif FSM2
`define ROM_DEPTH 6586
`define ROM_FILE  "ch02.mem"
`elsif FSM3
`define ROM_DEPTH 27814
`define ROM_FILE  "ch03.mem"
`endif

interface ROM_ifc;
   (* always_ready *) method Action req(Addr_t addr);
   (* always_ready *) method Data_t data();
endinterface

(* synthesize *)
`ifdef FSM0
module mkSoundROM0(ROM_ifc);
`elsif FSM1
module mkSoundROM1(ROM_ifc);
`elsif FSM2
module mkSoundROM2(ROM_ifc);
`elsif FSM3
module mkSoundROM3(ROM_ifc);
`endif
   BRAM_PORT#(Addr_t, Data_t) rom <- mkBRAMCore1Load(`ROM_DEPTH, False, `ROM_FILE, False);
   method Action req(Addr_t addr) = rom.put(False, addr, ?);
   method Data_t data = rom.read;
endmodule

FSMはそれを中に置き、readMemでreqを呼び、データはrom.dataで読みます。インタフェースからrom_dataとrom_addressが消え、addrとromdataの2つのレジスタも消えました。

interface FSM_ifc;
   method Action sound(SoundCode_t incode);
   method Action sync(Bool lrclk);
   method Action empty(Bool flag);
   method Data_t sdout();
   method Bool soundon();
   method Bool fifo_ren();
endinterface
   // 効果音 ROM。機能が別なので末尾の別モジュール mkSoundROMn にしてあり、
   // 本FSMはそれを置いて readMem で req と data を呼ぶ。
`ifdef FSM0
   ROM_ifc rom <- mkSoundROM0;
`elsif FSM1
   ROM_ifc rom <- mkSoundROM1;
`elsif FSM2
   ROM_ifc rom <- mkSoundROM2;
`elsif FSM3
   ROM_ifc rom <- mkSoundROM3;
`endif
   function Stmt readMem;
      return (seq
         rom.req(worka);
         noAction;
         noAction;
      endseq);
   endfunction
            if (ii == 3) dcount <= truncate(workd<<8) | extend(rom.data);
            else workd <= workd<<8 | extend(rom.data);
               action
                  son <= True;
                  dout <= rom.data;
               endaction

reqの中身は次の周期からdataに出て、次のreqまで保持されます。前の形ではaddrレジスタ、rom.vの出力レジスタ、romdataレジスタの3段を経てデータが届いていたので、readMemの2つのnoActionはそのための待ちでした。ROMの読み出しが1段になった後も、noActionはそのまま残してサイクル数を変えていません。ROMのreqはFSMの状態からだけ呼ばれるので、always_enabledは付けず、呼ばれた周期だけBRAMのENが立ちます。

sound.vはmkSoundFSM0から3を直接4つ置く形になり、sndch.vとrom.vは消えました。

   mkSoundFSM0 u_ch0 (
      .CLK(snd_fsmclk), .RST_N(snd_xrst), .sync_lrclk(LRCLK), .sound_incode(scode),
      .empty_flag(fifo_empty), .fifo_ren(ren0), .sdout(ch_out0), .soundon(ch_on0)
   );

動作は、旧sndch.vと新mkSoundFSMnを4チャネルとも同じ乱数のROM内容、同じコマンド列、同じlrclkで並走させて確かめました。SND_FSMCLKで300万サイクル、コマンド852件、再生中の周期がチャネル合計で488万あり、fifo_ren、soundon、sdoutの3出力が全周期一致しました。


左矢前のブログ 次のブログ右矢

メモリをBSVで書く (3)

posted by sakurai on October 3, 2026 #1134

2点目 VRAMをmkVramにする

図1134.1
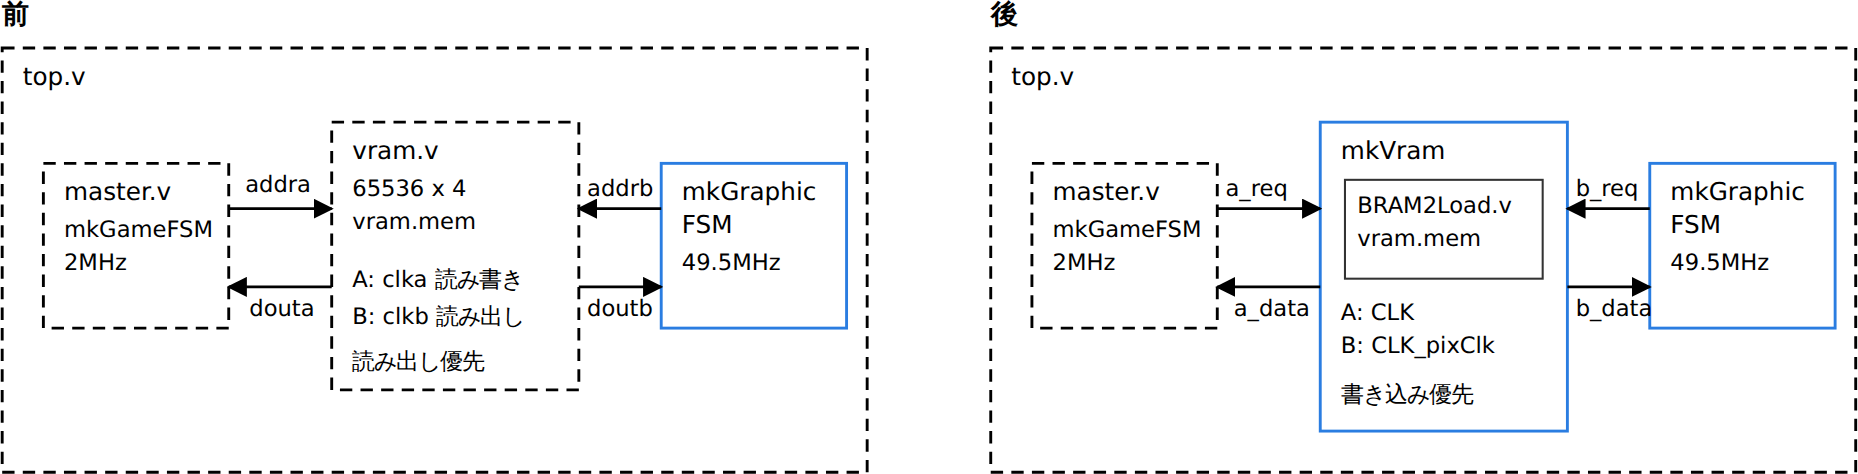
図1134.1 VRAM書き換え前後

VRAMは2ポート2クロックのTrue Dual Portです。ポートAはゲームFSMの2MHzで読み書き、ポートBはグラフィクスFSMの49.5MHzで読み出しだけです。手書きのvram.vはこうでした。

書き換え前

module vram #(
   parameter DEPTH = 65536,
   parameter FILE  = "vram.mem"
) (
   input  wire        clka,
   input  wire        wea,
   input  wire [15:0] addra,
   input  wire [3:0]  dina,
   output reg  [3:0]  douta,

   input  wire        clkb,
   input  wire [15:0] addrb,
   output reg  [3:0]  doutb
);

   reg [3:0] mem [0:DEPTH-1];
   initial $readmemh(FILE, mem);

   always @(posedge clka) begin
      if (wea) mem[addra] <= dina;
      douta <= mem[addra];
   end

   always @(posedge clkb) doutb <= mem[addrb];

endmodule

書き換え後のVram.bsvは次のとおりで、これが全文です。

package Vram;

// ================= VRAM =================
// 256x256、4bit/画素の画面メモリ。True Dual Port で、ポート A はゲーム FSM の
// クロックで読み書き、ポート B はグラフィクス FSM のピクセルクロックで読み出し。
// BRAMCore ライブラリの mkSyncBRAMCore2Load がそのまま実体で、初期値は
// vram.mem を $readmemh で読む。両ポートとも毎周期アクセスする always_enabled で、
// 生成 Verilog の BRAM2Load は EN が常に 1 になる。

import BRAMCore::*;

typedef Bit#(16) VAddr_t;
typedef Bit#(4)  Pattern_t;

interface Vram_ifc;
   // ポート A: ゲーム FSM 側。既定クロック
   (* always_ready, always_enabled *)
   method Action    a_req(Bool we, VAddr_t addr, Pattern_t d);
   (* always_ready *)
   method Pattern_t a_data;
   // ポート B: グラフィクス側。pixClk
   (* always_ready, always_enabled *)
   method Action    b_req(VAddr_t addr);
   (* always_ready *)
   method Pattern_t b_data;
endinterface

(* synthesize *)
module mkVram#(Clock pixClk, Reset pixRst)(Vram_ifc);
   Clock clkA <- exposeCurrentClock;
   Reset rstA <- exposeCurrentReset;
   BRAM_DUAL_PORT#(VAddr_t, Pattern_t) ram <-
      mkSyncBRAMCore2Load(65536, False, clkA, rstA, pixClk, pixRst, "vram.mem", False);

   method Action    a_req(Bool we, VAddr_t addr, Pattern_t d) = ram.a.put(we, addr, d);
   method Pattern_t a_data = ram.a.read;
   method Action    b_req(VAddr_t addr) = ram.b.put(False, addr, ?);
   method Pattern_t b_data = ram.b.read;
endmodule

endpackage

2つ目のクロックはモジュールの引数で受けます。mkVram#(Clock pixClk, Reset pixRst)と書くと、生成VerilogにCLK_pixClkとRST_N_pixRstの入力が増えます。自分のクロックはexposeCurrentClockで取り出し、mkSyncBRAMCore2Loadの2組のクロックとリセットに渡します。ポートBのメソッドb_reqとb_dataは、BRAMのポートBがpixClkで動いていることからbscがクロック域を推論するので、clocked_byを書く必要がありません。両ポートにalways_enabledを付けたのは、vram.vと同じく毎周期読む形にするためで、生成VerilogのBRAM2LoadはENAとENBが定数1になります。

トップの接続は、vram.vのパラメータ付きインスタンスがbsc生成モジュールの接続に変わるだけです。

書き換え前

   vram #(.DEPTH(65536), .FILE("vram.mem")) u_vram (
      .clka  (clk_2m),
      .wea   (vwe_a),
      .addra (vaddr_a),
      .dina  (vdout_a),
      .douta (vdin_a),
      .clkb  (C49_5MHz),
      .addrb (vaddr_b),
      .doutb (vram_qb)
   );

書き換え後

   mkVram u_vram (
      .CLK          (clk_2m),
      .RST_N        (locked),
      .CLK_pixClk   (C49_5MHz),
      .RST_N_pixRst (locked),
      .a_req_we     (vwe_a),
      .a_req_addr   (vaddr_a),
      .a_req_d      (vdout_a),
      .a_data       (vdin_a),
      .b_req_addr   (vaddr_b),
      .b_data       (vram_qb)
   );

1つだけ振る舞いの違いがあります。vram.vはポートAで書き込みと同じ周期に読んだ値が書き込み前の内容になる読み出し優先で、bscのBRAM2Load.vは書き込んだ値が出る書き込み優先です。ブリッタは読む状態と書く状態を分けていて、書く周期の読み出し値を使う箇所がありません。それを確かめるために、vram.vとmkVramを同じ乱数の読み書きで並走させました。ポートAは2MHz、ポートBは49.5MHzで、ポートAは書き込みの無い周期の読み出し値を20万周期分比べて不一致0、書き込みの周期だけが46,666回違いました。ポートBは、ポートAが同じ番地に書いている瞬間を除いた4,799,764回の読み出しが全て一致しました。同じ番地への同時アクセスはどちらのモデルでも未定義で、設計上も起きません。

Yosysでは、mkVramがRAMB36E1を8個使い、LUTとFFは0です。vram.vのVivadoでの実装も8個でしたから、物量は同じです。


左矢前のブログ 次のブログ右矢

メモリをBSVで書く (2)

posted by sakurai on October 2, 2026 #1133

書き換え後は、Blitter.bsvにmkPromというROMのモジュールを立て、ブリッタはそれを置いてreqとdataを呼ぶだけにします。mkPromの実体はBRAMCoreのmkBRAMCore1Loadで、引数は語数、出力レジスタの有無、ファイル名、ファイルが2進かどうかです。

import StmtFSM::*;
import FIFOF::*;
import BRAMCore::*;
// MemPort: 画面メモリ側の面。PROM は内蔵なので VRAM のポート A だけが出る
interface MemPort;
   (* always_ready *) method VAddr_t   vaddr;
   (* always_ready *) method Bool      vwe;
   (* always_ready *) method Pattern_t vdout;
   (* always_enabled *) method Action vdin(Pattern_t d);
endinterface
// ================= パターン ROM =================
// 25728 x 4 の同期 ROM。prom.mem を $readmemh で読む。req したアドレスの内容が
// 次の周期から data に出る。実体は BRAMCore ライブラリの mkBRAMCore1Load で、
// 生成 Verilog では bsc 付属の BRAM1Load.v がインスタンスされる。
// FSM とは機能が別なので、ブリッタの中に置く別モジュールにしてある。
// 語数は PROM_DEPTH で作り分けられる(テストベンチ用)。
`ifdef PROM_DEPTH
   Integer promDepth = `PROM_DEPTH;
`else
   Integer promDepth = 25728;
`endif

interface Prom_ifc;
   (* always_ready *) method Action    req(PAddr_t addr);
   (* always_ready *) method Pattern_t data;
endinterface

(* synthesize *)
module mkProm(Prom_ifc);
   BRAM_PORT#(PAddr_t, Pattern_t) rom <- mkBRAMCore1Load(promDepth, False, "prom.mem", False);
   method Action    req(PAddr_t addr) = rom.put(False, addr, ?);
   method Pattern_t data = rom.read;
endmodule
   Reg#(VAddr_t) v_addr <- mkRegU;
   Reg#(Bool) fvwe <- mkReg(False);
   Reg#(Bool) fobj  <- mkReg(False),
              fbase <- mkReg(False);
   Reg#(Pattern_t) vd <- mkRegU;
   Wire#(Pattern_t) vdata <- mkWire;

   // パターン ROM。機能は mkProm という別のモジュールで、ブリッタはそれを置いて
   // req と data を呼ぶだけ。階層図では mkBlitter の中に mkProm の箱として見える。
   Prom_ifc prom <- mkProm;
               action
                  prom.req({pack(ys)[7:0], pack(xs)[6:0]});
                  UInt#(8) y_addr = truncate(yd);
                  UInt#(8) x_addr = truncate(xd);
                  v_addr <= {pack(y_addr), pack(x_addr)};
               endaction
               noAction; // リード待ち(1サイクル)
               action
                  case (b.op)
                     BLIT_COPY:  vd <= prom.data;
                     BLIT_OR:    vd <= vdata | prom.data;
                     BLIT_ANDN:  vd <= vdata & ~prom.data;
                     BLIT_ERASE: vd <= 0;
                  endcase
                  xs <= xs + 1;
                  xd <= xd + 1;
               endaction
   interface MemPort mem;
      method VAddr_t   vaddr     = v_addr;
      method Bool      vwe       = fvwe;
      method Pattern_t vdout     = vd;
      method Action vdin(Pattern_t d); vdata   <= d; endmethod
   endinterface

アドレスを置くactionはレジスタへの代入からprom.reqに、ラッチのactionはワイヤからprom.dataに変わりました。reqしたアドレスの内容は次の周期からdataに出るので、間のnoActionを含めて1画素あたりのサイクル数は変わりません。消えたのはp_addrレジスタ、romdataワイヤ、MemPortの2ポート、mkGameFSMの同名の2ポート、master.vのROMインスタンスと2本の配線です。mkPromは(* synthesize *)付きなので生成物にmkProm.vが1つ増え、Vivadoの階層図ではmkBlitterの中にmkPromの箱が出ます。ブリッタのFSMとROMが別のモジュールであることが、字面でも階層図でも見えます。

生成されたmkProm.vの中では、bsc付属のBRAM1Load.vがFILENAMEにprom.mem、MEMSIZEに25728を与えてインスタンスされます。BRAM1Load.vの中が$readmemhなので、memの運用は今までと同じです。語数はpromDepthにあり、テストベンチのように別の語数で作りたいときは-D PROM_DEPTH=32768のように与えます。


左矢前のブログ 次のブログ右矢

メモリをBSVで書く

posted by sakurai on October 1, 2026 #1132

教科書版の手書きVerilogは、トップの配線、メモリ、クロック生成の3つでした。このうちメモリは、BSVの標準ライブラリBRAMCoreがそのまま当てはまる部分で、手書きのVerilogを残す理由がありません。パターンROM、VRAM、サウンドROMの3つをBSVのモジュールにしました。どれも初期値は今までどおりmemの$readmemhで読み、Vivadoの運用は変わりません。合成はYosysのsynth_xilinx、動作確認はVerilatorとiverilogで、前回までと同じ条件です。

置き場所を決める物差しは、機能が別なら別モジュール、というものです。FSMはROMを読む機能、ROMは内容を持つ機能で、2つは別のモジュールにします。そのうえで、ROMを読むのがそのFSMだけなら、ROMのモジュールはそのFSMの中に置き、FSMがメソッドで呼びます。パターンROMはブリッタの中に、サウンドROMはサウンドFSMの中に置きました。VRAMは2つのクロック域から共有されるので、独立のモジュールとしてトップに置いたままです。

1点目 パターンROMをブリッタの中に置く

図1132.1
図1132.1 パターンROM書き換え前後

パターンROMを読むのはブリッタだけです。それなのにROMはmaster.vにあり、ブリッタはアドレスをレジスタp_addrに置いて外に出し、読み出しデータをワイヤromdataで受けていました。ブリッタのMemPortにはprom_addrとpdinの2ポートがあり、mkGameFSMにも同じ名前のポートが素通しで並んでいました。

書き換え前

// MemPort: 画面メモリ側の面
interface MemPort;
   (* always_ready *) method PAddr_t   prom_addr;
   (* always_ready *) method VAddr_t   vaddr;
   (* always_ready *) method Bool      vwe;
   (* always_ready *) method Pattern_t vdout;
   (* always_enabled *) method Action pdin(Pattern_t d);
   (* always_enabled *) method Action vdin(Pattern_t d);
endinterface
   Reg#(PAddr_t) p_addr <- mkRegU;
   Reg#(VAddr_t) v_addr <- mkRegU;
   Reg#(Bool) fvwe <- mkReg(False);
   Reg#(Bool) fobj  <- mkReg(False),
              fbase <- mkReg(False);
   Reg#(Pattern_t) vd <- mkRegU;
   Wire#(Pattern_t) vdata <- mkWire,
                    romdata <- mkWire;
               action
                  p_addr <= {pack(ys)[7:0], pack(xs)[6:0]};
                  UInt#(8) y_addr = truncate(yd);
                  UInt#(8) x_addr = truncate(xd);
                  v_addr <= {pack(y_addr), pack(x_addr)};
               endaction
               noAction; // リード待ち(1サイクル)
               action
                  case (b.op)
                     BLIT_COPY:  vd <= romdata;
                     BLIT_OR:    vd <= vdata | romdata;
                     BLIT_ANDN:  vd <= vdata & ~romdata;
                     BLIT_ERASE: vd <= 0;
                  endcase
                  xs <= xs + 1;
                  xd <= xd + 1;
               endaction
   interface MemPort mem;
      method PAddr_t   prom_addr = p_addr;
      method VAddr_t   vaddr     = v_addr;
      method Bool      vwe       = fvwe;
      method Pattern_t vdout     = vd;
      method Action pdin(Pattern_t d); romdata <= d; endmethod
      method Action vdin(Pattern_t d); vdata   <= d; endmethod
   endinterface

master.vにはROMのインスタンスと、そこへ渡す2本の配線がありました。

   wire [14:0] prom_addr;
   wire [3:0]  prom_dout;

   mkGameFSM u_game (
      .CLK          (clk),
      .RST_N        (rst_n),
      .COUNT        (COUNT),
      .START_BUTTON (start_db),
      .LEFT_BUTTON  (left_db),
      .RIGHT_BUTTON (right_db),
      .FIRE_BUTTON  (fire_db),
      .tick         (tick),
      .empty        (fifo_empty),
      .fifo_wen     (fifo_wen),
      .SCODE        (scode),
      .prom_addr    (prom_addr),
      .pdin         (prom_dout),
      .vaddr        (vaddr),
      .vdout        (vdout),
      .vwe          (vwe),
      .vdin         (vdin),
      .Gun_Exp      (gun_exp)
   );

   rom #(.WIDTH(4), .AWIDTH(15), .DEPTH(25728), .FILE("prom.mem")) u_prom (
      .clk  (clk),
      .addr (prom_addr),
      .q    (prom_dout)
   );

左矢前のブログ 次のブログ右矢

GameFSMの結果

posted by sakurai on September 26, 2026 #1131

Vivado 2026.1で合成したゲーム全体の各モジュールの物量を表1131.1に示します。ロジックはすべてBSVで記述し、トップ配線とメモリ、クロック生成のみVerilogで書いています。論理合成はトップからのフラット合成で、物量は階層別レポートから読みました。小さなモジュールはフラット合成で親に吸収され計上されるため、その分は親の残差として示し、注記します。

表1131.1 各モジュールの物量
モジュール 説明 BSV行数 生成Verilog行数※1 物量
LUT数 LUT割合[%] FF数 FF割合[%] BRAM数
mkGameFSM 自機、インベーダ、UFO、自弾、敵弾、スコア等を処理するFSM 1,554 31,439 2,904 48.7 1,807 73.0 -
mkBlitter VRAMへの矩形転送、消去、衝突判定を実行するFSM(mkGameFSMから分離) 335 1,406 2,073 34.8 128 5.2 -
mkSoundFSM3 UFO音を演奏するFSM 261※2 1,968 215 3.6 116 4.7 -
mkSoundFSM0 自弾発射音、自機爆発音、自機増加音を演奏するFSM 1,821 201 3.4 116 4.7 -
mkSoundFSM2 インベーダ歩行音を演奏するFSM 1,823 198 3.3 109 4.4 -
mkSoundFSM1 インベーダ爆発音を演奏するFSM 1,796 193 3.2 109 4.4 -
mkGraphicFSM VGA映像信号生成回路 196 410 54 0.9 33 1.3 -
mkParaSeri サウンドパラシリ変換、タイミング生成回路 77 251 23※3 0.4 39※3 1.6 -
mkOneStage ゲームFSMとサウンドFSMの間のバッファ 62 201
mkMixer 4チャネルのサウンドミキサー 59 133
mkButtons スイッチとボタンをORする回路 36 102 85※4 1.4 0 0 -
clock クロック制御回路 - 84 11※5 0.2 19※5 0.8 -
vram ビデオRAM - 34 - - - - 8
sound_rom0 自弾発射音、自機爆発音、自機増加音を格納するROM - 26※6 - - - - 8
sound_rom3 UFO音を格納するROM - - - - - 8
sound_rom1 インベーダ爆発音を格納するROM - - - - - 2
sound_rom2 インベーダ歩行音を格納するROM - - - - - 2
pattern_rom 自機、インベーダ、UFO、自弾、敵弾、スコア等の図形を格納するROM - - - - - 4
合計 5,958 100 2,476 100 32
  • ※1 bscが生成するVerilogには、$displayによるエラー・デバッグ表示やルール衝突検知など、合成時に除去されシミュレーションでのみ働く記述が含まれる。合成対象となるのは概ね半分程度で、この行数がそのまま記述の圧縮率を表すわけではない。
  • ※2 BSVのソースは1つで、defineにより0~3のバリエーションを生成する。
  • ※3 mkParaSeri、mkOneStage、mkMixerはフラット合成で親のsoundモジュールに吸収され計上されるため、階層別レポートに個別の行が立たない。3つの合計を、soundの物量から4つのサウンドFSMを引いた残差として示す。
  • ※4 mkButtonsは親のmasterモジュールに吸収されるため、masterの残差として示す。トップ配線のグルーロジックを含む。
  • ※5 clockはトップ直下に吸収されるため、トップの残差として示す。
  • ※6 ROM(rom.v)は共通のパラメタ化モジュールで、4つのサウンドROMとパターンROMが同一ソースを共有する。

左矢前のブログ 次のブログ右矢


ページ: